顾客明明满意,为什么最后还是没发?
我最早是在给 KikiMajo Studio 调研 NFC 冰箱贴时想到 Tap to Share 的。当时已经有商家把 NFC 用在 Google Review 上:顾客碰一下,就能直接打开评论页面,不用再自己搜索。
但我很快意识到,打开页面其实只是第一步。真正麻烦的是后面:写什么、怎么写、配什么图、发到哪里,都需要顾客继续花时间。
我自己作为顾客也经常这样。体验明明不错,也愿意支持商家,但一想到还要写内容、找图、选平台,最后往往就算了。
对商家来说,这套流程同样麻烦。做社交参与活动时,员工常常要反复说明活动规则、在哪里发、怎样发,以及有哪些图片或海报可以用;如果活动设有奖励,还要处理兑换和发放。这里说的是社交活动奖励,不是用奖励换取正面的 Google Review。
一个关于顾客行为的假设
满意体验不会自动变成公开表达。
现有摩擦
- 顾客满意
- 愿意支持商家
- 还要想内容 · 写文案 · 找素材 · 选平台
- 最后没有行动
降低摩擦的假设路径
- 顾客满意
- 在最愿意分享的时候收到提示
- 减少步骤 + 可修改文案 + 现成素材
- 更容易参与 / 分享
顾客在特别满意的当下,可能已经愿意分享,只是后面的操作和表达成本让他们停了下来。Tap to Share 想测试的是:如果在这个时候减少步骤,再提供可修改的文案和现成素材,参与会不会变得更容易。这个判断仍需要真实数据验证。
为什么负面体验更容易被看见?
我在 BabySquare 也见过这个问题的另一面。一位不满意的顾客曾公开批评门店的售后体验,但门店当时其实一直在协助处理厂商保修。具体身份和沟通内容不会出现在案例里。真正让我记住的是:不满意的顾客往往更有动力公开发声,满意的顾客却很可能什么都不发。
为什么负面声音更容易被看见?
网上能看到的声音,并不一定完整代表所有顾客的真实体验。
不满意的顾客
有明确的发声动机
- 更可能主动发布
满意的顾客
体验结束后往往直接离开
- 未必会主动分享
品牌声誉韧性
如果一家商家长期积累了更多真实的顾客体验,一次负面帖子就不容易代表外界对它的全部印象。
Tap to Share 想做的,是让真实顾客更容易分享真实体验,而不是制造好评。
第一版:预设文案
第一版 Framer Demo 是我刻意做得很简单的:先给顾客一段可以直接使用的文案,让他们不用从零开始写。分享确实更快了,但新问题也很快出现——不同顾客拿到的内容太相似,发出来容易像统一发稿,而不是各自的真实表达。
解决了什么
- 不用从零开始写
- 分享更快
- 参与门槛更低
又带来了什么问题
- 文案容易重复
- 多个顾客像统一发稿
- 反而影响真实感
为什么我从预设文案改用 AI
预设文案让分享更省事,却也让内容越来越容易被看出规律。下一步很自然:改用 AI,让不同顾客拿到不同的文案。但真正难的并不是“写出不同版本”,而是让这些版本符合具体的顾客、场景、语言和平台,不要换了措辞,读起来却还是同一种“AI 味”。
文字不同,不代表表达自然。普通 AI 输出仍可能反复使用相似句式、泛泛的营销语言,或者写得过度完整,和实际平台上的表达习惯不符。因此,Tap to Share 需要一套带有具体背景和规则的生成方式,而不是简单的“提示词 → AI → 文案”。
从不同文案,到真正可用的文案起点
生成不同文案并不难,更难的是让它像不同顾客在具体场景中可能采用的表达。
商家背景 · 活动背景 · 顾客选择 · 平台写法 · 不同语言分别处理 · 减少 AI 味 · 顾客继续修改
结合商家和活动背景
文案先要知道商家是谁、这次活动在讲什么。
参考顾客选择
顾客选了什么,会影响文案重点。
适配不同平台
语气、结构和 Hashtag 会根据发布平台调整。
按不同语言分别写
英文、简体中文和繁体中文各自处理,不做机械翻译。
减少 AI 味
尽量避开重复句式、空泛营销话术和过度修饰。
顾客可以继续修改
生成结果只是起点,最终表达由顾客决定。
主要证据
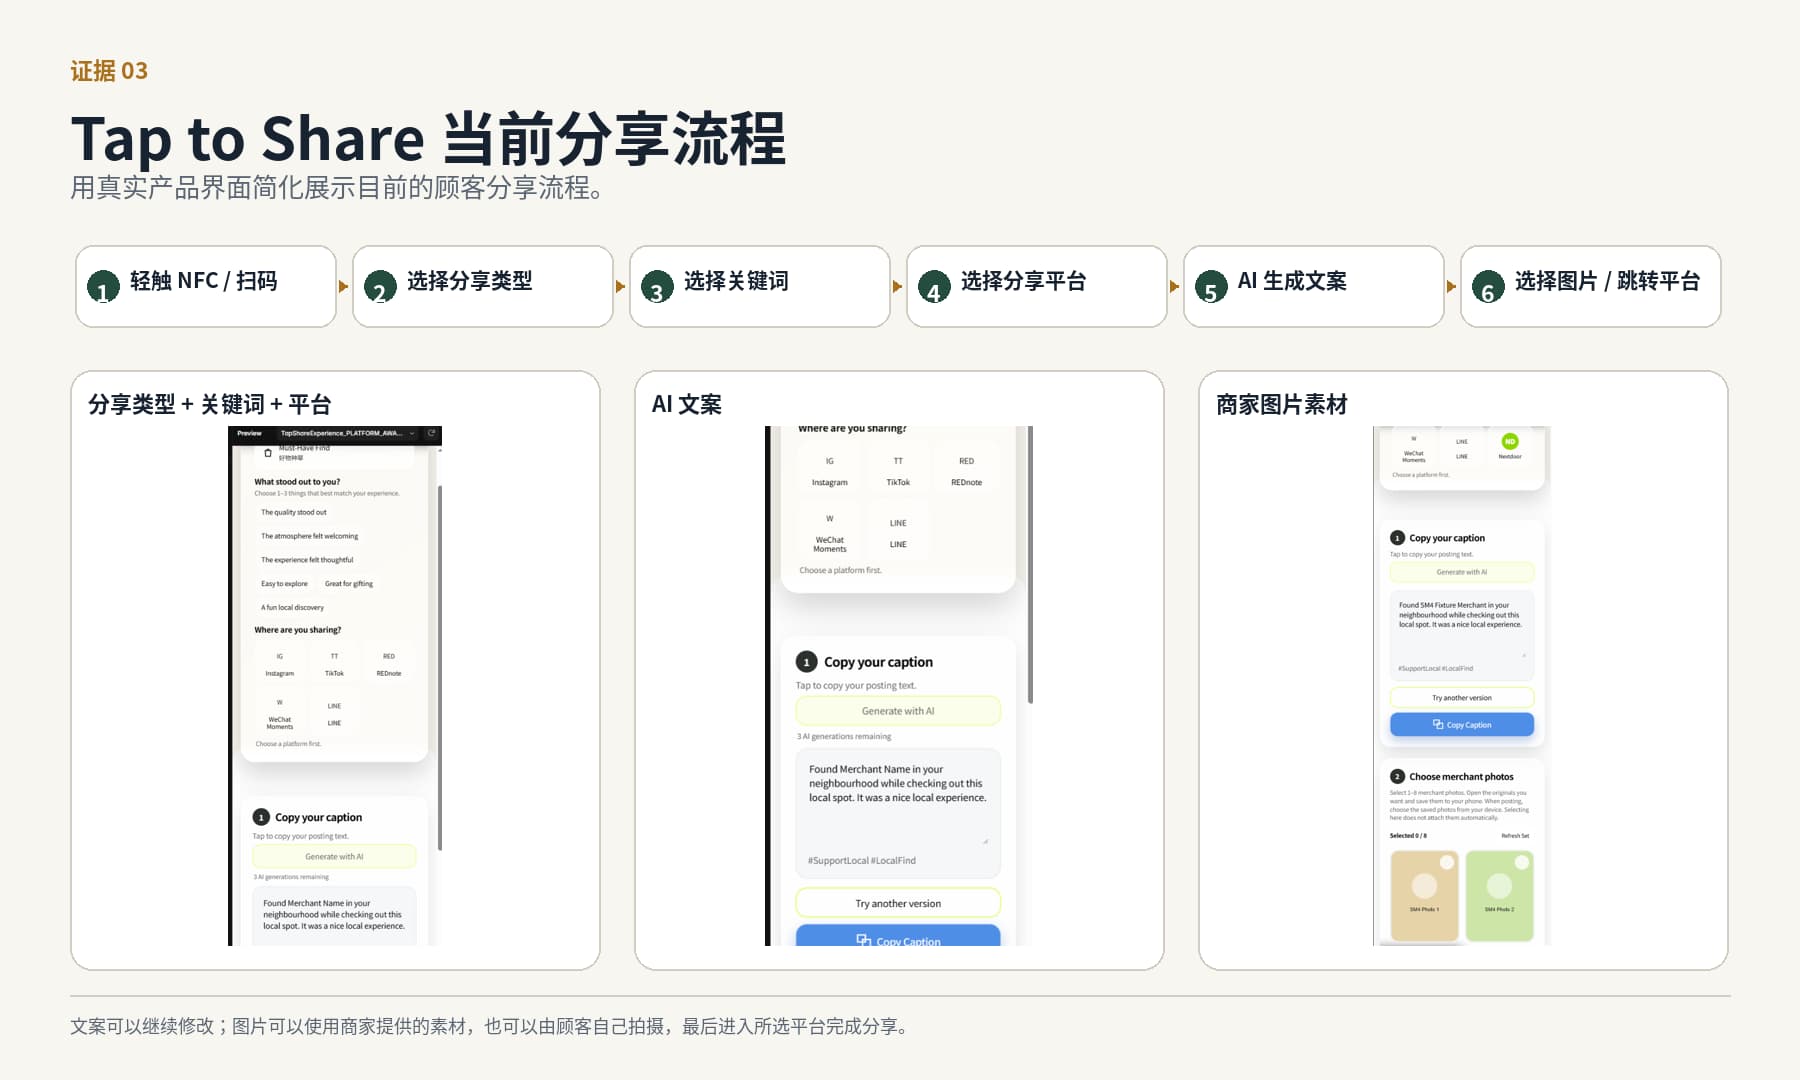
当前 Tap to Share 流程:选择分享方向和平台,生成并修改 AI 文案,再决定是否使用素材并前往相应平台。
缩短从想法到测试的距离
以前,一个想法要变成可以测试的产品,前面有很多工作:先查市场、整理信息、判断值不值得做,再把想法写成开发需求,找开发者沟通、等待、验收、反馈、修改。很多时候,假设还没开始测试,时间已经花在来回沟通上。
以前的流程
想法到测试之间要经过多次交接
- 有一个想法
- 自己查资料、判断机会
- 整理成开发需求
- 寻找并沟通开发者
- 等待、验收、解释偏差、再修改
- 反复进行,直到可以测试
现在的流程
步骤更短,但判断仍由我负责
- 有一个想法
- AI 辅助的市场与关键词研究
- 判断:这个想法值不值得测试?
- 定义 MVP
- 用 Codex 完成开发
- 测试 ↔ 调整
研究时,我会做市场探索、查询词和关键词发现,也会分析搜索意图。我也会通过 Monid 这类 API 工具做结构化的关键词和搜索研究,再结合结果判断市场里常用什么说法、用户怎样搜索,以及后续内容可以往哪里走。工具提供信息,产品判断仍由我来做。
研究方向、产品决定、MVP 范围、需求、AI 行为规则、QA 和迭代都由我负责。AI 用在研究、分析和需求整理上,Codex 负责代码开发。这样,构建、测试和调整之间少了很多外部交接。
以前,一个想法要真正做出来测试,往往先要投入开发时间和沟通成本。现在,我可以先自己把研究、MVP 和第一轮测试跑起来,再决定值不值得继续投入更多资源。
Tap to Share 不只是一个分享页面
产品继续往下做以后,我开始发现,Tap to Share 的价值不只是一段 AI 文案。商家需要先把活动背景、可用素材和分享方向设置清楚。我也开始规划怎样利用互动数据辅助后续营销判断。下面的流程包含未来的衡量层;目前 PostHog 采集尚未启用,商家后台尚未上线。
商家提供环境,顾客决定怎么表达
商家可以设置分享方向和可用素材,但最终说什么、改什么、发不发,仍由顾客决定。
活动背景、关键词、Hashtag、素材、平台和参与说明都可以提前设置,但商家不会替顾客写意见。
- 商家先设置活动背景
关键词
Hashtag
图片 / 素材
开放的平台 - 顾客参与轻触 NFC / 扫码
了解活动
选择想分享的方向
AI 生成 / 自己修改
使用现成素材
打开平台 - UGC / 分享行为顾客决定
用什么
怎样修改
最后是否发布 - 计划观察的数据选了哪些关键词
用了哪些素材
打开哪些平台
哪些触点带来了参与 - 未来辅助商家判断以后讲什么
用什么素材
重点看哪些渠道
哪些触点更有效
这套自助流程可以减少员工反复解释规则和传递素材的工作,但不会让所有运营任务消失。未来的价值也可能不只是一篇帖子:观察顾客选择、素材使用、平台点击和触点参与,可能为后续判断提供线索。这些是待验证的衡量问题,目前不是已经提供给商家的报表。
产品做出来之后,下一步是增长
已经完成 / 具备
- 进入付费测试的产品基础
- 商家和活动配置
- Shared Media
- 已上线的营销网站
正在搭建 / 测试
- 产品迭代与测试反馈
- SEO/GEO 内容与关键词研究
- 自然搜索获客与转化假设
- 衡量计划:PostHog 采集尚未启用
- 商家后台:尚未上线
计划:观察顾客行为,辅助营销判断
未来在数据足够时,顾客的实际选择可用于提出下一步问题。
未来测试框架
- 顾客选择了哪些关键词
- 可能帮助判断: 帮助判断内容主题和定位
- 顾客用了哪些素材
- 可能帮助判断: 帮助判断什么视觉更容易被采用
- 顾客打开了哪些平台
- 可能帮助判断: 帮助判断可以重点观察哪些渠道
- 哪些触点带来了参与
- 可能帮助判断: 帮助判断 NFC 或活动适合放在哪些场景
数据本身不会直接告诉商家答案。要先看顾客实际选了什么、用了什么、在哪里参与,再结合样本量和业务背景判断这些行为可能说明什么。一次选择不等于已经证明了偏好。等积累了足够的真实数据后,我再评估 SEO/GEO、获客和转化表现。